Tsinghua ouvre le code d’AKV pour réduire de 27,7 % le coût du cache des agents
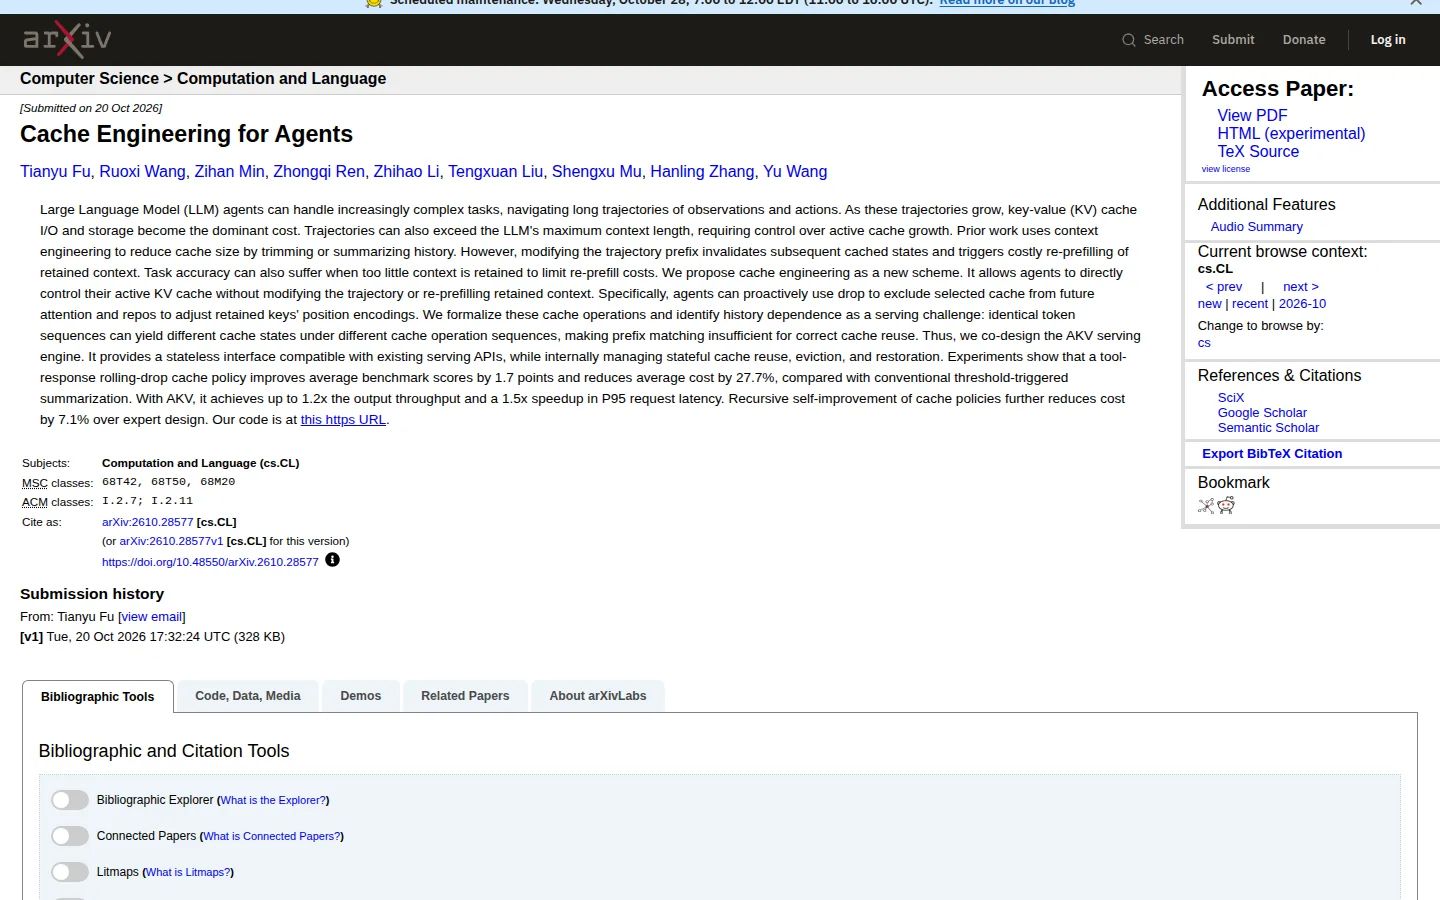
Neuf chercheurs, dont huit à l’université Tsinghua, ont publié un article intitulé Cache Engineering for Agents sur arXiv le 20 octobre 2026, et le code associé se trouve dans un dépôt public sous licence Apache-2.0 créé le 28 septembre. Le moteur s’appelle AKV et tourne sur SGLang. L’affirmation figurant sur la page de l’article est précise et chiffrée : un agent qui gère lui-même son cache clé-valeur obtient en moyenne 1,7 point de plus sur quatre benchmarks d’agents, et coûte 27,7 % de moins, qu’un agent qui résume son historique de la manière habituelle.
Ce qui a réellement été publié
AKV scinde le problème en deux. Côté agent, une politique de cache décide quels messages retirer du cache et quand déplacer les tokens qui restent. Côté système, ces opérations sont exécutées dans un serveur SGLang qui conserve un endpoint Chat Completions compatible OpenAI, de sorte qu’un harnais d’agent existant lui parle sans modification.
Le mécanisme repose sur deux opérations que l’article formalise. Drop retire des tours de conversation sélectionnés de l’attention future sans modifier le texte fourni au modèle. Repos réencode la position des clés conservées, afin qu’un cache raccourci reste cohérent en interne. La trajectoire elle-même n’est jamais réécrite, et c’est tout l’intérêt : un préfixe réécrit est un préfixe mort, et un préfixe mort doit être re-prefillé depuis zéro.
Ce qui est disponible aujourd’hui
- Le dépôt thu-nics/AKV, sous licence Apache-2.0, créé le 28 septembre 2026, dont les derniers commits datent du 21 octobre.
- Un paquet Python qui installe ensemble la politique de l’agent et le système de serving, plus un point d’entrée serveur.
- Un quick start qui sert GPT-OSS-120B avec un parallélisme tensoriel de deux et applique une politique conservant les résultats d’outils du dernier tour complété.
Le quick start du dépôt est une recette qui fonctionne, pas une esquisse : une toolchain Rust, un environnement Python 3.12, une installation du paquet, puis une commande de lancement pointée vers un répertoire de modèle local. Ce qui manque, c’est un numéro de version, car aucune n’a été taguée.
Sur quoi repose l’affirmation
Les 27,7 % ne sont pas une facture payée par les auteurs. Les coûts de l’article sont donnés en cents américains par tâche, calculés à partir des tarifs de tokens publiés, ceux de Groq pour GPT-OSS-120B, ceux de MiniMax pour MiniMax-M2.7, et ceux de Qwen3-30B-A3B, le modèle de base de MiroThinker-1.7-Mini, appliqués à l’agent principal et à ses appels de résumé. Chaque token repositionné est facturé au tarif de cache-hit, ce qui, selon l’article, surestime délibérément le coût de la rotation de clés. L’économie est un modèle d’économie, bâti sur une grille tarifaire déclarée.
La référence de comparaison change aussi selon la section lue. Le résumé compare à la summarization classique déclenchée par seuil ; la section 5.2 donne 27,7 % face à l’exécution brute non tronquée et 21,9 % face au text engineering. Les deux proviennent des propres exécutions des auteurs sur leur propre harnais, moyennées sur trois modèles et quatre benchmarks.
Le problème technique que l’article nomme est précisément ce qui rend la chose difficile à copier au niveau applicatif :
Des séquences de tokens identiques peuvent produire des états de cache différents selon les séquences d’opérations de cache, ce qui rend le prefix matching insuffisant pour une réutilisation correcte du cache.
Regardez les cellules, pas la moyenne. Sur SWE-Verified, MiroThinker-1.7-Mini obtient 7,4 sous AKV contre 7,8 sur l’exécution brute, donc le gain affiché masque une perte, et l’article ne discute pas cette ligne. Son coût sur le même benchmark baisse en revanche, de 33,6 cents à 26,3.
| Modèle | Exécution brute : score / coût | Text engineering : score / coût | AKV : score / coût |
|---|---|---|---|
| MiniMax-M2.7 | 52,4 / 5,0 | 52,8 / 5,7 | 53,7 / 4,4 |
| GPT-OSS-120B | 51,0 / 11,2 | 48,3 / 10,2 | 53,1 / 7,3 |
| MiroThinker-1.7-Mini | 44,1 / 20,4 | 37,1 / 18,1 | 45,8 / 14,8 |
Taux de réussite moyen sur quatre benchmarks d’agents et coût moyen par tâche en cents américains, tels que publiés dans le tableau 1 de l’article. Un score plus élevé est meilleur, un coût plus bas est meilleur, et le coût est calculé à partir des tarifs de tokens, non facturé.
Les chiffres de serving proviennent d’une expérience distincte, pas des mêmes exécutions : un débit de sortie multiplié par 1,18 et une latence P95 des requêtes 1,51 fois plus rapide sur huit GPU A800-80GB, quatre pour le prefill et quatre pour le decode, en BF16 car l’A800 n’a pas de support natif du MXFP4. Le résumé arrondit à 1,2x et 1,5x et les nuance d’un jusqu’à.
Ce que l’article ne montre pas
- Aucune exécution indépendante. Chaque chiffre est celui des auteurs, sur leur propre harnais, sur quatre benchmarks et trois modèles à poids ouverts.
- Aucune empreinte mémoire ou de stockage par session, si bien que la taille de la facture GPU qu’AKV crée lui-même ne peut pas être déduite de l’article.
- Aucune comparaison avec le prompt caching que les API commerciales vendent désormais, et aucun prix en dollars pour le servir soi-même.
- Aucun tag de version sur le dépôt, dont les commits les plus récents sont des modifications de documentation.
Ce que cela change pour les équipes qui font tourner leurs propres agents
Si vous louez des tokens auprès d’une API hébergée, AKV ne change rien aujourd’hui. Le drop et les repos doivent être exécutés par le serveur qui détient le cache, et ce serveur n’est pas le vôtre. Votre levier reste la troncature et le résumé, avec la facture qui va avec.
Si vous servez des agents sur SGLang, le code est exécutable et l’intérêt n’est pas l’économie affichée en titre. C’est le constat qu’une politique qui retire les anciens résultats d’outils un par un bat un seuil. Dans le test de l’article, l’ingénierie de contexte par troncature qui ne conservait que les 12 derniers tours de réponses d’outils a coûté 1,85 fois la référence en contexte complet, parce que la coupe invalide le préfixe mis en cache et force un re-prefill. Retirer les tours un par un, avant que le contexte n’atteigne un plafond, évite cette falaise. Ce résultat vaut plus que le pourcentage, car il s’applique à quiconque a une politique de contexte, quel que soit le moteur utilisé.
Trois choses à mesurer avant d’en croire quoi que ce soit pour votre propre charge de travail : le coût par tâche résolue sur vos trajectoires, la part de votre facture qui relève de l’entrée mise en cache plutôt que de l’entrée fraîche, et la fréquence à laquelle la politique de mémoire de votre agent jette quelque chose dont il a besoin trois étapes plus tard.
L’avis de Neural Minute
Chaque fournisseur d’agents vend désormais des agents de longue durée et un contexte généreux. Cet article est la preuve publique la plus claire que nous ayons lue que la règle d’élagage au sein de ces agents est le coût par tâche résolue, pas le coût par million de tokens. Deux agents sur le même modèle, au même tarif publié, peuvent atterrir à un tiers d’écart sur la facture selon le moment où ils oublient, et la page tarifaire d’aucun des deux fournisseurs ne le montre.
Il fixe aussi une limite à la façon dont nous le citons. Une économie de 27,7 % mesurée en cents modélisés face à la référence des auteurs eux-mêmes n’est pas un prix qu’un acheteur verra, et une publication de code sans tag de version, c’est de la recherche que vous pouvez reproduire, pas un service que vous pouvez acheter. Nous n’avons pas exécuté AKV, nous n’avons aucun chiffre indépendant, et nous ne maquillerons pas son tableau en nôtre. Si vous hébergez SGLang vous-même et que vos agents sont longs, cela vaut une semaine de mesure. Si vous payez OpenAI ou Anthropic au token, le drop et les repos exigent un serveur qui vous appartient, et aujourd’hui ce n’est pas à vous de résoudre ce problème.
Sources
L’article : Cache Engineering for Agents, arXiv 2610.28577, soumis le 20 octobre 2026 et lu le 26 octobre 2026. Tous les chiffres ci-dessus viennent de cette page et de l’article qui la sous-tend, y compris le tableau de benchmark et les mesures de serving.
Le code : le dépôt thu-nics/AKV sur GitHub, Apache-2.0, créé le 28 septembre 2026, son historique de commits lu le 26 octobre 2026. L’article y renvoie directement depuis sa page de résumé.
Aucune autre source n’a été utilisée pour cet article, et aucune couverture de cette publication n’a été lue pour les chiffres.