

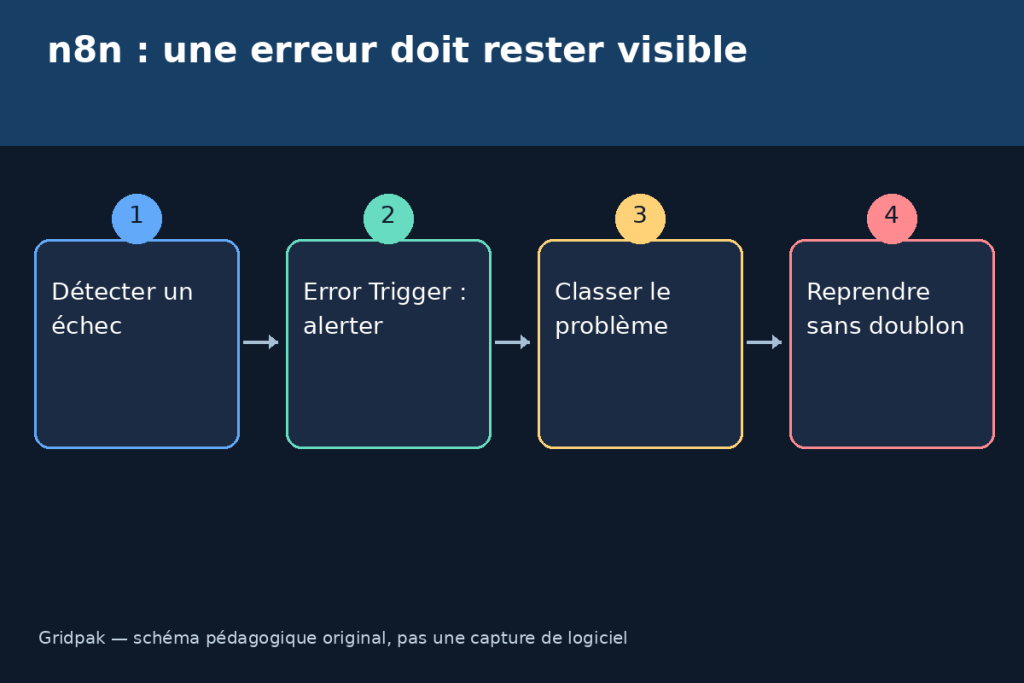
Une automatisation n8n fiable ne consiste pas à masquer les erreurs. Elle doit savoir où ça casse, quoi notifier, quand relancer et comment éviter de créer deux fois la même action. La documentation n8n recommande de prévoir des méthodes de gestion d’erreur et permet d’utiliser un workflow d’erreur pour contrôler la réponse à un échec d’exécution.
1. Créer un workflow d’erreur
Créez un nouveau workflow séparé nommé par exemple _error-handler-production. Ajoutez un nœud Error Trigger. Ce workflow ne traite pas la logique métier : il reçoit le contexte de l’échec. Ajoutez ensuite un nœud Set pour construire un message court : nom du workflow, nom du nœud en échec, message d’erreur, identifiant d’exécution et URL de l’exécution si disponible.
Envoyez cette synthèse vers Slack, Discord, email ou une base de suivi. Ne notifiez pas tout le JSON brut. L’alerte doit permettre de décider : corriger une donnée, relancer, désactiver, ou ignorer.
2. Brancher le workflow d’erreur
Dans le workflow métier, ouvrez les paramètres du workflow et sélectionnez le workflow d’erreur créé. Testez avec une erreur volontaire : URL d’API invalide, champ obligatoire absent, ou code HTTP bloqué. Vérifiez que l’alerte mentionne le nœud fautif et l’exécution. Sans ce test, vous ne savez pas si l’alerte fonctionne avant l’incident réel.
3. Utiliser les retries sans confondre reprise métier
Un retry est utile pour une erreur transitoire : timeout, 429, réseau instable. Il n’est pas une stratégie pour corriger une donnée invalide. Si une API externe répond 429, attendez selon les informations disponibles et limitez le nombre d’essais. Si un champ client manque, stoppez et envoyez en file de correction.
n8n expose aussi le cas d’une exécution relancée après échec. Traitez cette situation comme une reprise : relisez ce qui a déjà été fait avant de créer une nouvelle ressource.
4. Rendre la reprise idempotente
Avant chaque action qui crée quelque chose, calculez une clé stable : source_id + type_action + version_metier. Stockez-la dans Airtable, Postgres, Google Sheets ou un datastore. Avant de créer un ticket, un email ou une publication, cherchez cette clé. S’il existe déjà, mettez à jour le statut au lieu de recréer. Le simple réflexe “je vérifie puis j’écris” peut échouer en concurrence : si deux exécutions tournent en même temps, privilégiez une contrainte unique côté base.
5. Limites à documenter
- Une relance manuelle peut réexécuter des nœuds déjà passés.
- Un retry automatique ne corrige pas une erreur de logique.
- Une notification utile doit être courte et actionnable.
- Les actions externes doivent avoir une clé de déduplication.
Exemple de message d’alerte
Workflow: {{$json.workflow.name}}
Execution: {{$json.execution.id}}
Node: {{$json.execution.lastNodeExecuted}}
Erreur: {{$json.execution.error.message}}
Adaptez les chemins aux données réellement reçues par votre Error Trigger. L’important est que l’opérateur voie immédiatement où agir. Ajoutez aussi une règle de silence : si l’erreur est déjà connue et en cours de reprise, mettez à jour le ticket existant au lieu d’envoyer dix alertes identiques.
File d’attente de reprise
Pour les workflows critiques, créez une table failed_jobs avec clé métier, erreur courte, payload réduit et statut. L’Error Trigger ajoute une ligne si elle n’existe pas. Un workflow de reprise lit uniquement les lignes retryable. Cela évite les relances manuelles improvisées depuis l’historique n8n.
Un vrai déclenchement pour tester Error Trigger
Un clic sur Execute Workflow dans l’éditeur ne suffit pas : Error Trigger ne s’exécute pas pour une exécution manuelle. Déclenchez le workflow métier par son déclencheur de production, avec des données fictives et un nœud Stop And Error réservé à cet essai. Retirez ce nœud après contrôle. L’erreur doit être non gérée : continuer malgré une erreur peut empêcher l’exécution d’être considérée comme échouée.
Dans les réglages du nœud, Retry On Fail permet une reprise bornée lorsque le problème est transitoire. Vérifiez le nombre de tentatives et l’attente, sans supposer que le nœud respecte automatiquement toutes les consignes du service distant. Ne stockez jamais comme « réussi » une action dont la réponse s’est perdue : conservez un état à réconcilier.


