OpenAI publie 165 activités professionnelles alors que la part du top 10 recule
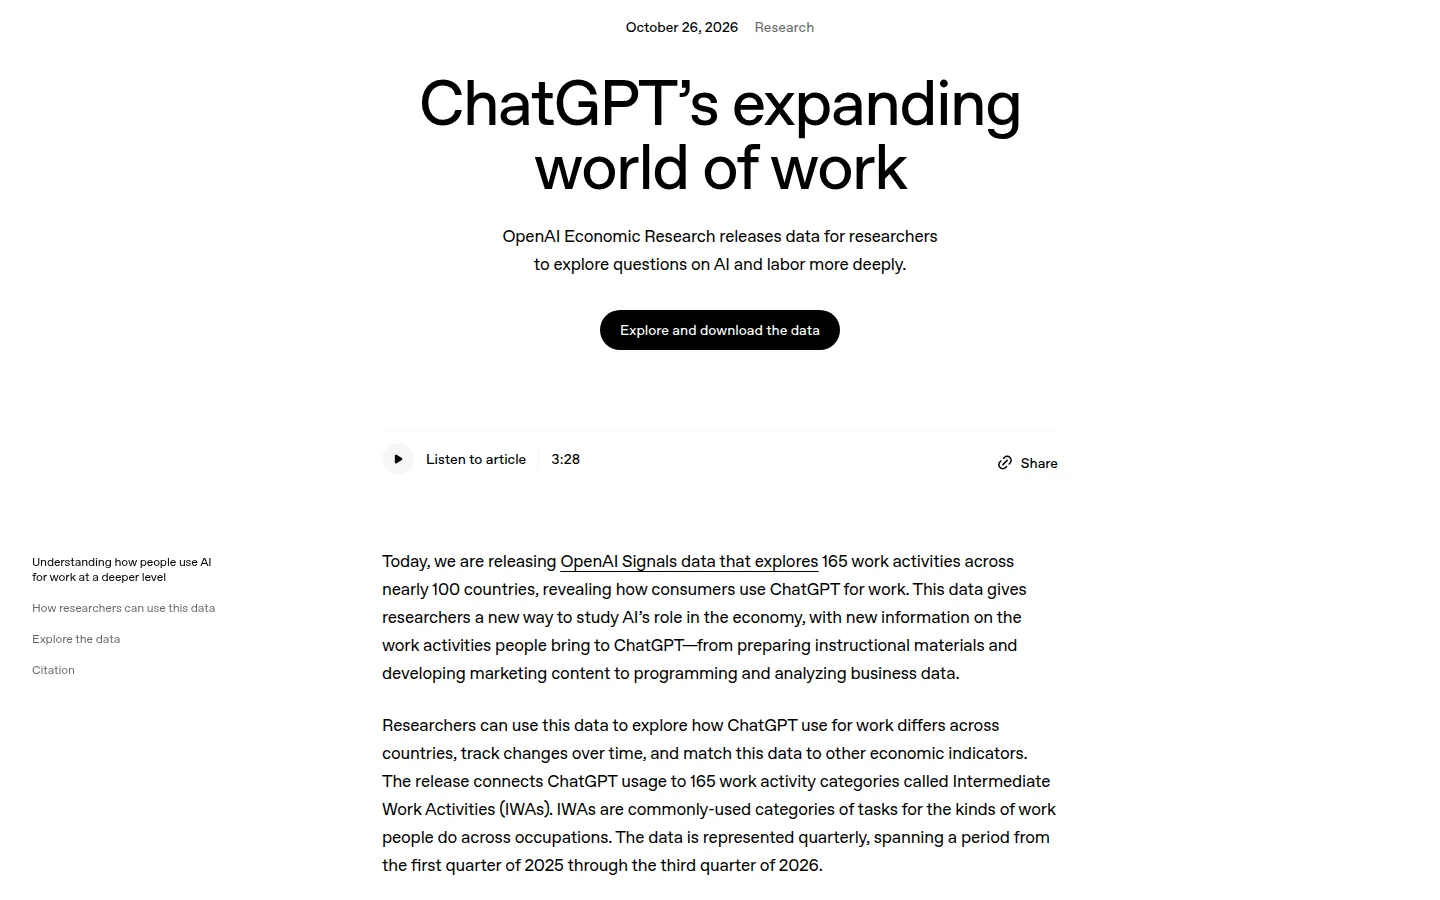
OpenAI a publié OpenAI Signals le 26 octobre 2026, un jeu de données de son équipe de recherche économique qui rattache les messages ChatGPT liés au travail à 165 activités professionnelles dans près de 100 pays. Les données sont trimestrielles, vont du premier trimestre 2025 au troisième trimestre 2026, et OpenAI les propose en téléchargement. La lecture mise en avant par l’entreprise est que l’usage professionnel s’est moins concentré : sur les 74 pays observés à chaque trimestre, les dix activités les plus courantes représentaient en moyenne 51,1 % des messages professionnels classés de chaque pays au troisième trimestre 2026, contre 56,0 % au premier trimestre 2025.
Ce qui a réellement été publié
Aucun modèle, aucune fonctionnalité, aucun changement de prix. Ce qu’OpenAI a publié est une mesure : un ensemble de statistiques qui relie l’usage de ChatGPT à 165 catégories de tâches qu’elle appelle Intermediate Work Activities, ou IWA. Ces catégories s’appuient sur O*NET, le référentiel du département du Travail des États-Unis qui regroupe les tâches propres à chaque métier en catégories d’activités plus larges. Emprunter une taxonomie publique est justement le but : des catégories partagées permettent à un chercheur de placer l’usage de ChatGPT à côté de données d’emploi construites sur la même base.
La publication s’accompagne d’un explorateur interactif, pays par pays, qui descend des grands groupes d’activités jusqu’aux tâches individuelles sur sept trimestres. Une seconde vue place la répartition de ChatGPT à côté des activités réellement exercées dans les emplois américains.
| Dimension | Ce que publie OpenAI |
|---|---|
| Activités professionnelles | 165, regroupées en Intermediate Work Activities construites sur O*NET |
| Pays | près de 100, dont 74 sont observés à chaque trimestre |
| Période | du premier trimestre 2025 au troisième trimestre 2026, par trimestre |
| Offres concernées | messages liés au travail sur les offres ChatGPT individuelles |
| Hors périmètre | messages entreprise et usage de Codex |
| Concentration | 51,1 % des messages professionnels classés dans les dix activités les plus courantes par pays, troisième trimestre 2026 |
| Accès | graphique interactif dans la page, plus un téléchargement des données pour les chercheurs |
Lu sur la page d’annonce le 26 octobre 2026. Les 51,1 % sont la moyenne sur les 74 pays présents à chaque trimestre, et non une part de tous les messages ChatGPT.
Ce qu’il faut retenir de la publication
- L’usage professionnel se diffuse : les dix activités les plus courantes sont passées de 56,0 % à 51,1 % des messages professionnels classés sur les 74 pays observés à chaque trimestre.
- La série est trimestrielle, couvre sept trimestres et s’accompagne d’un téléchargement, ce que la plupart des études d’éditeurs ne proposent pas.
- Les pays ne convergent pas vers les mêmes tâches. OpenAI indique que les pays ont eu tendance à se spécialiser dans différents types de travail au fil du temps.
Sur quoi repose l’affirmation
Le chiffre de concentration est une moyenne de moyennes par pays, et la page publie l’agrégat, pas la distribution derrière. Une baisse de 4,9 points de la part des dix premières activités est compatible avec un usage professionnel qui s’étend vers une longue traîne, et elle est aussi compatible avec quelques grands marchés qui bougent pendant que la plupart des pays restent stables. Le lecteur ne peut pas trancher à la lecture de la page : les valeurs par pays vivent dans le graphique interactif, pas dans un tableau publié, et aucun intervalle autour de la moyenne n’est donné.
La seconde mesure est plus fragile qu’elle n’en a l’air. OpenAI soutient que les pays se sont spécialisés différemment au fil du temps. Son graphique porte deux valeurs imprimées pour la distance de variation totale moyenne, 22,2 % et 23,0 %, sur les sept trimestres représentés. Un mouvement de 0,8 point sur cette échelle est faible, et le texte ne rattache aucun des deux chiffres à un trimestre nommé, si bien que la tendance repose sur le seul graphique.
La mesure est aussi automatisée. Les messages sont classés en activités par des systèmes automatisés après suppression des informations identifiantes, ce que la page présente comme une mesure de protection de la vie privée. C’en est aussi une de méthode : les parts ci-dessus mesurent autant les affectations du classifieur que les comportements, et la page ne publie ni taux de précision ni audit des étiquettes. Si la frontière entre l’analyse de données métier et la création de contenu marketing se déplace d’un trimestre à l’autre, la concentration bouge sans que personne change ce qu’il fait au travail.
Sur les 74 pays observés à chaque trimestre, les dix activités les plus courantes représentaient en moyenne 51,1 % des messages professionnels classés de chaque pays au troisième trimestre 2026, contre 56,0 % au premier trimestre 2025.
La comparaison avec l’économie américaine est partielle par construction. Environ 43 % du mélange de tâches pondéré par l’emploi pour les métiers américains cartographiés tombent dans des catégories que la publication regroupe comme autres IWA, hors de celles rapportées individuellement : déplacer des matériaux, conduire des véhicules, tenir des dossiers de santé ou médicaux. Elles n’ont pas atteint le seuil d’OpenAI pour une représentation cohérente dans son échantillon américain, et forment donc la part du travail américain que le graphique ne peut pas voir.
Ce qu’OpenAI ne publie pas
Aucun volume : les nombres de messages, d’utilisateurs et de revenus sont absents, si bien qu’aucune part ne peut être convertie en estimation du travail effectué. Aucune donnée entreprise ni Codex, qui est la surface que les entreprises paient. Aucune précision du classifieur et aucun audit des étiquettes. Et aucun tableau par pays ni barre d’erreur derrière l’une ou l’autre des mesures de concentration, alors que c’est ce qui rendrait les deux tendances vérifiables plutôt qu’indicatives.
Ce que cela change pour les acheteurs d’outils IA
Trois décisions en découlent.
La première est l’étendue d’une évaluation. Si l’usage professionnel du pays moyen s’étale désormais sur une liste d’activités plus longue, la question d’achat passe de quel modèle gagne un benchmark à quel outil tient bon sur les cinq tâches qu’une équipe apporte réellement. Un modèle convaincant en démo et médiocre sur la troisième et la quatrième tâche hebdomadaire est le plus cher, et c’est là que va le volume.
La seconde est le segment. Le jeu de données ne mesure que les offres individuelles. Si vous achetez pour une entreprise, les preuves publiques sur l’usage de l’IA par les entreprises viennent encore surtout d’études de cas d’éditeurs, et une étude de cas mesure un déploiement choisi pour être publié. La seule mesure qui décrit votre usage est celle que vous demandez à votre fournisseur : sièges, tâches, rétention, et ce qu’il advient d’un siège qui reste inutilisé.
La troisième est la façon de lire les chiffres d’exposition des métiers. Comme 43 % du mélange de tâches professionnelles américaines se situe hors des activités cartographiées, une faible activité ChatGPT dans un secteur ne prouve pas que ces emplois sont hors de portée. Cela signifie souvent que le travail est physique ou fondé sur des dossiers, et qu’il n’a jamais été mesuré.
Une mise en garde pour l’estimation de marché : traitez les parts comme des ordres de grandeur, pas comme des chiffres précis. La direction est étayée, les décimales ne le sont pas.
L’avis de Neural Minute
Nos propres éléments vont dans le même sens, vus de l’autre côté de la table. Nous couvrons un flux régulier de déploiements clients, et chacun décrit un projet choisi pour être publié : un cabinet d’avocats qui construit un outil de relecture de contrats, une équipe sécurité qui réduit le temps de correctif, un distributeur qui annonce un gain d’engagement, une société de bases de données qui compte ses licences (un exemple récent). Chacun est réel et chacun est un meilleur cas, or un acheteur n’entre pas dans un meilleur cas. L’intérêt de cette publication, c’est qu’elle mesure la distribution dans laquelle un acheteur entre réellement, et c’est pourquoi nous préférons orienter le lecteur ici plutôt que vers une nouvelle histoire client.
Le deuxième point à relever, c’est ce qu’OpenAI a choisi de publier. Les données sur le marché du travail sont devenues une surface marketing, et le vrai test d’une publication comme celle-ci, ce sont ses omissions : aucune donnée entreprise, pas de Codex, aucun chiffre de précision. Un jeu de données qui s’arrête exactement là où commence le produit payant est un jeu de données sur les particuliers, pas sur le travail tel que les entreprises l’achètent.
Cela pose une règle que nous appliquons déjà : citer le chiffre qui flatte le moins. Ici, c’est le 0,8 point de variation entre pays et le chiffre de précision manquant, pas la baisse de 4,9 points.
Sources
- ChatGPT’s expanding world of work, OpenAI, 26 octobre 2026. L’annonce, les chiffres et le graphique interactif cités plus haut.
- OpenAI Signals data download, OpenAI, Signals v3.0. Le jeu de données et sa note méthodologique, cités par l’annonce.