

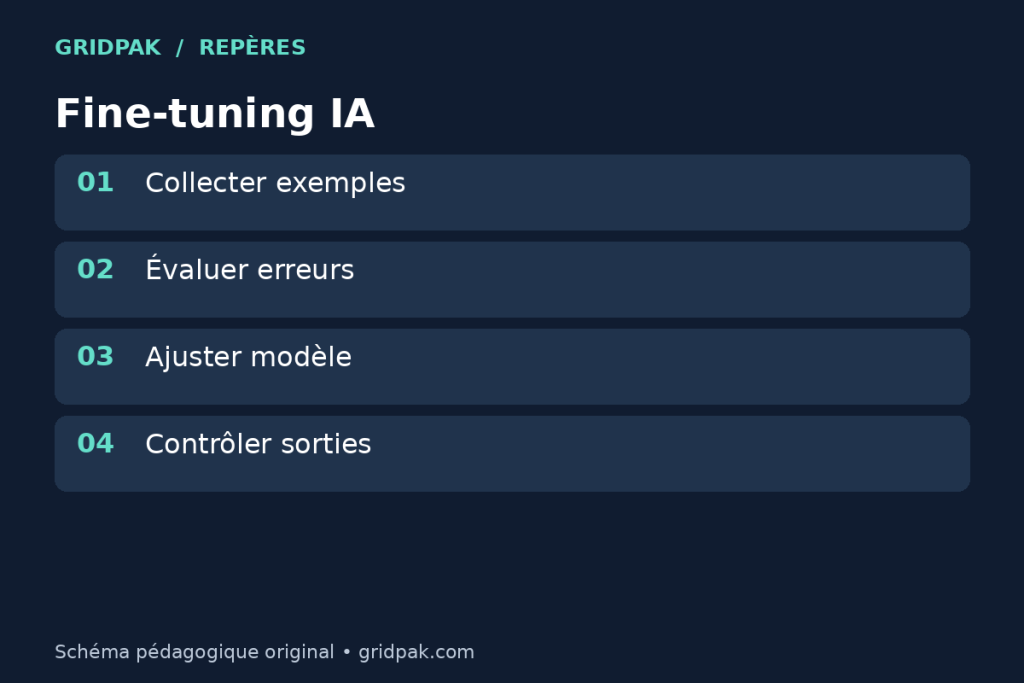
Le fine-tuning est une phase d’entraînement supplémentaire qui modifie les poids, donc les paramètres, d’un modèle déjà préentraîné. Ce n’est pas seulement “donner de meilleures consignes” au modèle. Un prompt, un RAG ou un fichier de règles changent le contexte envoyé à l’inférence ; le fine-tuning change le modèle lui-même à partir d’exemples.
Repère documentaire : documentation officielle du fonctionnement présenté.
À quoi ça sert vraiment ?
Le fine-tuning est utile quand le comportement attendu est répétable et difficile à obtenir proprement par prompt : classification dans des catégories internes, format de sortie très stable, style court très spécifique, extraction normalisée, décision de routage. Il est moins adapté pour “apprendre toute une base documentaire” : dans ce cas, un moteur de recherche ou un RAG garde les sources à jour sans réentraîner.
Exemple simple : classification de tickets
Supposons un support client avec trois classes : facturation, bug, résiliation. Un jeu d’entraînement peut contenir des paires entrée/sortie :
Entrée: "On m'a prélevé deux fois ce mois-ci"
Sortie: {"categorie":"facturation"}

Entrée: "Le bouton exporter ne répond plus"
Sortie: {"categorie":"bug"}
On garde un jeu de validation distinct, jamais utilisé pour entraîner. Il sert à vérifier si le modèle progresse sur des exemples qu’il n’a pas vus. Un troisième jeu de test, idéalement gelé, permet de mesurer une version finale. Mélanger les exemples de test dans l’entraînement crée une fuite : le score paraît bon, mais il ne prédit plus la performance réelle.
Évaluer avant et après sans inventer de score
Avant fine-tuning, mesurez le modèle de base avec le même prompt, les mêmes entrées et la même grille : précision par classe, erreurs critiques, sorties JSON invalides, temps et coût. Après fine-tuning, repassez exactement le même protocole. Ne publiez pas “+30 %” parce que le ressenti est meilleur : calculez le nombre de cas corrects, faux positifs et faux négatifs. Le gain peut être fort, faible ou nul selon les données.
Données privées et pièges
Un dataset de fine-tuning est une matière sensible. Supprimez secrets, tokens, emails complets, données médicales ou identifiants clients inutiles. Gardez aussi les cas difficiles : ambiguïtés, demandes mixtes, messages courts, langues différentes. Si le modèle apprend seulement des exemples parfaits, il cassera sur la vraie production.
Erreur fréquente : fine-tuner trop tôt. Si dix exemples de prompt suffisent à stabiliser la sortie, commencez par là. Fine-tunez quand vous avez un volume d’exemples propres, une métrique de succès et un coût d’erreur clair. Sinon, vous obtenez un modèle plus coûteux à maintenir sans preuve qu’il résout mieux le problème.
Décision pratique
- Besoin de connaissances fraîches : RAG ou recherche, pas fine-tuning seul.
- Besoin de format stable et répétitif : fine-tuning envisageable.
- Peu d’exemples et règles mouvantes : prompt versionné.
- Données sensibles non nettoyées : ne pas lancer.
Le fine-tuning est donc un levier d’industrialisation, pas une baguette magique. Sa valeur se voit dans une évaluation reproductible avant/après.
Format et gouvernance du dataset
Un dataset de fine-tuning doit être versionné. Gardez la date, la source des exemples, la règle d’annotation et les exclusions. Si deux annotateurs ne classent pas pareil les mêmes tickets, le modèle apprendra une ambiguïté. Avant d’entraîner, corrigez les labels contradictoires et séparez les cas “hors périmètre”.
Signaux d’un mauvais candidat
Si la règle change chaque semaine, si la vérité dépend d’une base externe à jour, ou si l’équipe ne sait pas noter objectivement une réponse, fine-tuner est prématuré. Utilisez plutôt un prompt, une checklist, du RAG ou une validation humaine. Le fine-tuning devient rentable quand le comportement cible est stable et fréquent.
Pour les bases : définition d’un modèle de langage.


