

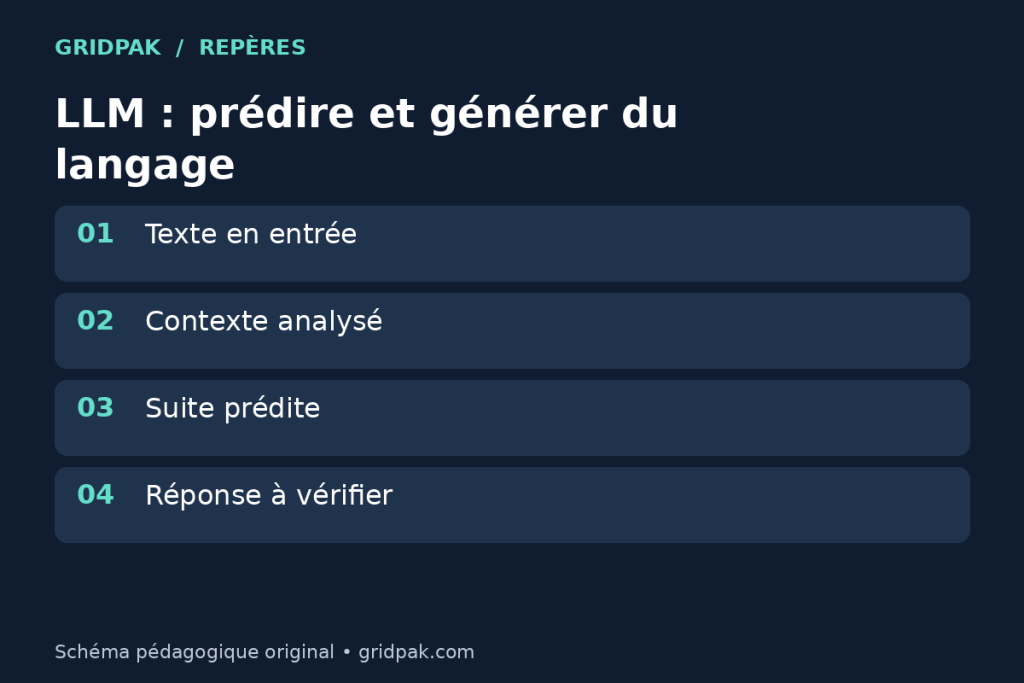
Un LLM, pour Large Language Model, est un grand modèle de langage entraîné sur de vastes ensembles de données afin de traiter et générer du langage naturel. Il peut résumer, reformuler, répondre, classer ou produire du code, mais il ne garantit pas automatiquement la vérité de ses réponses.
Le sujet est central dans les agents intelligents, car beaucoup d’agents modernes utilisent un LLM comme moteur de raisonnement textuel.
Mécanisme général
IBM décrit les LLM comme des modèles de deep learning, souvent basés sur l’architecture transformer, capables de traiter des séquences de mots et de capturer des motifs dans le texte. Ils fonctionnent comme de grands systèmes de prédiction statistique : à partir d’un contexte, ils prédisent les suites les plus plausibles.
Cette capacité explique leur souplesse. Un même modèle peut rédiger, résumer, analyser ou générer une réponse structurée. Mais la plausibilité n’est pas une preuve. Un texte fluide peut contenir une erreur factuelle.
Entraînement et utilisation : deux moments distincts
L’entraînement ajuste les paramètres numériques du modèle à partir de données. L’inférence est son utilisation : le modèle reçoit un contexte découpé en tokens et produit une suite de tokens. Lui transmettre une consigne ou un document ne signifie donc pas qu’il réentraîne ses paramètres à chaque conversation.
Les modalités de conservation et d’utilisation des conversations par un service sont une autre question, définie par ses réglages et conditions. Un modèle, l’application qui l’héberge et sa politique de données ne sont pas interchangeables.
Exemple illustratif
Exemple pédagogique : vous fournissez un paragraphe de politique interne et demandez au LLM d’en faire un résumé en trois points. Le résultat doit ensuite être vérifié contre le texte source, surtout si une décision opérationnelle dépend du résumé.
À ne pas confondre
- LLM et chatbot : le chatbot est l’interface ; le LLM peut être le modèle derrière.
- LLM et agent : un agent combine souvent un LLM avec outils, mémoire, règles et actions.
- LLM et base de vérité : le modèle produit du texte plausible, pas une garantie documentaire.
Limites et confidentialité
Les limites principales sont les hallucinations, les données périmées, le manque de contexte, la sensibilité aux consignes et la difficulté à expliquer précisément certaines réponses. En entreprise, il faut aussi décider quelles données peuvent être envoyées à un modèle cloud et lesquelles doivent rester locales.
Un LLM local peut améliorer la maîtrise des données, mais il ne supprime pas les risques : logs, prompts, fichiers indexés et sorties générées doivent être traités comme des éléments potentiellement sensibles.
Usage associé
Pour expérimenter localement, un outil comme Ollama peut lancer certains modèles sur votre machine. L’usage conseillé reste progressif : tester un petit cas, vérifier les réponses, mesurer les ressources utilisées, puis seulement ensuite brancher le modèle à un workflow.
Quand l’utiliser dans un projet
Un LLM est utile lorsque la tâche implique du langage non structuré : lire une note, proposer un plan, classifier un message, reformuler une réponse ou extraire des informations d’un texte. Il est moins adapté lorsqu’il faut une exactitude déterministe sans vérification, comme calculer un montant contractuel ou décider seul d’une action irréversible.
Pour un usage sérieux, encadrez le modèle avec des sources, des exemples attendus et une étape de contrôle. Demandez-lui de distinguer ce qui vient du document fourni, ce qui est une hypothèse et ce qui manque. Cette discipline réduit les réponses trop confiantes. Si des données privées sont en jeu, choisissez consciemment entre modèle local, modèle cloud et anonymisation préalable.
Le bon usage consiste donc à traiter le LLM comme un assistant de traitement du langage, pas comme un arbitre final. Sur un sujet technique, juridique ou financier, la réponse doit être reliée à une source vérifiable ou relue par une personne compétente.
Un autre point pratique concerne le contexte : plus la consigne est vague, plus le modèle complète les blancs avec des probabilités. Fournir l’objectif, le public, les limites et le format réduit ce risque sans l’annuler.
Pour aller plus loin
Pour expérimenter sur votre ordinateur, suivez le guide d’installation d’Ollama. Complétez avec le lexique des tokens IA et la définition du RAG documentaire.
Retrouvez les autres notions dans le lexique IA et automatisation de Gridpak.


