

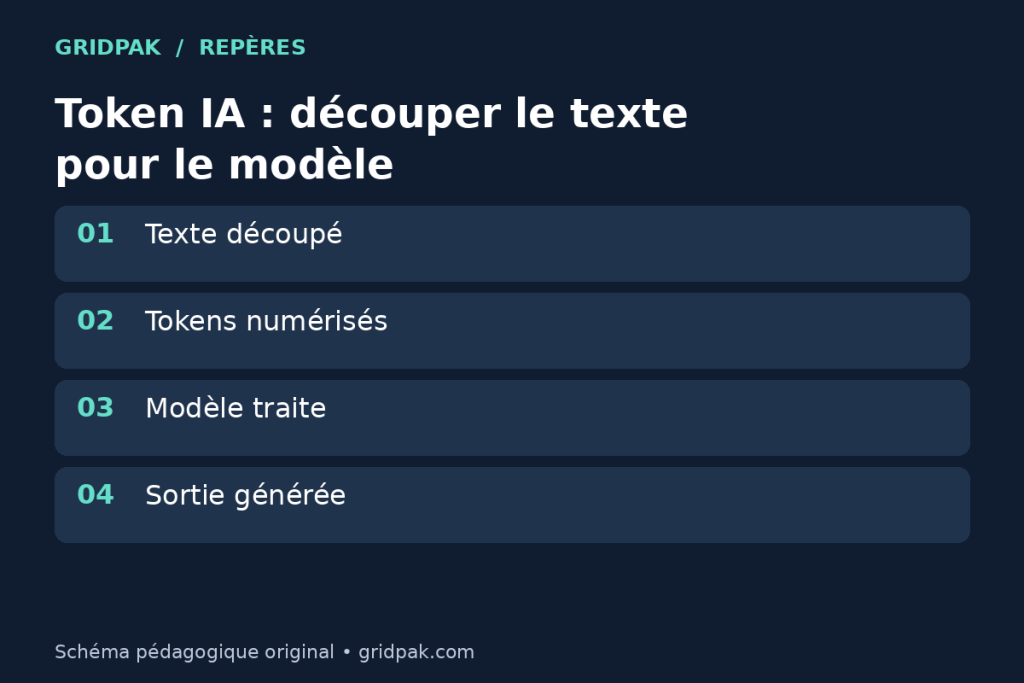
Un token IA est une unité de données issue de la tokenisation et traitée par un modèle. Dans un LLM, un token peut correspondre à un mot court, une partie de mot, un signe de ponctuation ou un fragment plus technique selon le tokenizer utilisé.
Les tokens sont importants pour comprendre les agents intelligents, car ils influencent la longueur du contexte, le coût, la vitesse et parfois la qualité des réponses.
Mécanisme général
NVIDIA explique que les modèles d’IA traduisent les données en jetons lors d’un processus appelé tokenization. Les modèles traitent ces jetons pour apprendre ou générer des relations. Dans les LLM, certains mots courts peuvent être représentés par un seul token, tandis que des mots plus longs peuvent être découpés en plusieurs tokens.
Il n’existe pas de ratio universel fiable du type “un token égale toujours un mot”. Le résultat dépend du modèle, de la langue, des accents, des espaces, de la ponctuation et du tokenizer.
Exemple illustratif
Exemple pédagogique : le mot anglais “darkness” peut être découpé en fragments comme “dark” et “ness” dans un tokenizer donné, avec des représentations numériques associées. En français, un mot composé, un accent ou une apostrophe peut produire un découpage différent. Pour un cas réel, il faut tester avec le tokenizer du modèle concerné.
À ne pas confondre
- Token et mot : un token n’est pas forcément un mot complet.
- Token de modèle et token d’accès : un token d’accès authentifie une requête à un service ; ce n’est pas une unité de texte traitée par le LLM.
- Token IA et cryptomonnaie : ici, il s’agit d’une unité de traitement du modèle, pas d’un actif blockchain.
- Tokens d’entrée et de sortie : le texte fourni et le texte généré consomment tous deux des tokens.
Limites et sécurité
Compter les tokens est utile pour éviter de dépasser une fenêtre de contexte, mais ce comptage ne juge pas la qualité du prompt. Un prompt court peut être mauvais ; un prompt long peut contenir trop d’informations sensibles. Avant d’envoyer un document à un modèle, supprimez les secrets, clés API, données client et informations contractuelles non nécessaires.
Les coûts et limites varient selon les plateformes et les modèles. Ne déduisez pas un prix ou une capacité à partir d’une règle générale trouvée ailleurs : vérifiez toujours la documentation du fournisseur utilisé.
Usage associé
Dans un workflow IA, surveiller les tokens aide à découper les documents, résumer les entrées et éviter de saturer le modèle. C’est aussi une bonne base pour comprendre pourquoi un RAG ou un outil local doit sélectionner seulement les passages pertinents.
Quand le surveiller dans un projet
Le nombre de tokens devient important dès que vous traitez des documents longs, des historiques de conversation, des exports clients ou des bases de connaissances. Trop de texte peut dépasser la fenêtre de contexte ou noyer l’information utile. Trop peu de contexte peut produire une réponse hors sujet.
La bonne pratique consiste à découper l’information avant l’appel au modèle : garder la question, les passages utiles, les contraintes et le format attendu. Pour un RAG, cela veut dire récupérer quelques extraits pertinents plutôt que coller toute la documentation. Pour un prompt manuel, cela veut dire retirer les répétitions et secrets avant envoi. La fenêtre de contexte et la limite de sortie sont à vérifier séparément : disposer d’un grand contexte n’autorise pas forcément une réponse aussi longue. Les interfaces peuvent aussi ajouter des consignes et un historique invisibles dans le champ de saisie, qui occupent une partie du budget.
Pour aller plus loin
Le fonctionnement d’un LLM replace les tokens dans la génération. Le guide pour installer Ollama propose un premier modèle local, sans assimiler taille du téléchargement et taille du contexte.
Retrouvez les autres notions dans le lexique IA et automatisation de Gridpak.


