

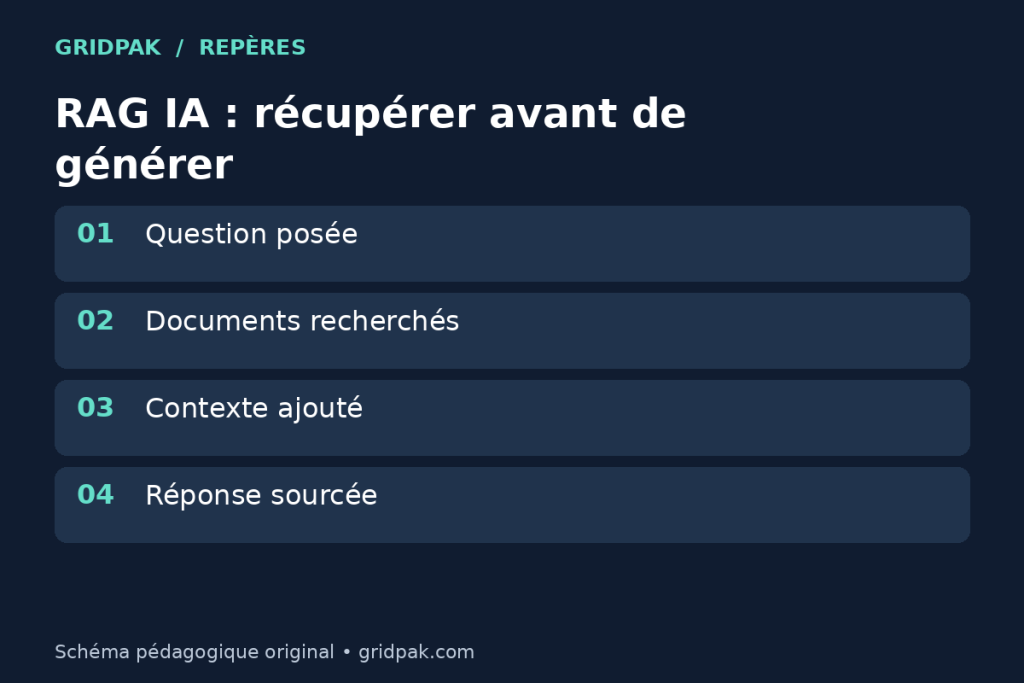
Le RAG IA, pour Retrieval-Augmented Generation, consiste à récupérer des documents pertinents puis à les ajouter au contexte d’un modèle avant génération. L’objectif est d’ancrer la réponse dans une base documentaire au lieu de laisser le modèle répondre uniquement depuis ses données d’entraînement.
Dans une architecture d’agents intelligents, le RAG sert souvent à connecter un assistant à une documentation interne, une base de connaissances ou des procédures métier.
Mécanisme général
AWS décrit le RAG comme un processus qui optimise la sortie d’un LLM en lui faisant référencer une base de connaissances externe faisant autorité avant de générer une réponse. Le pipeline typique contient une question, une recherche de passages pertinents, l’ajout de ces passages au prompt, puis la génération de la réponse.
Le RAG ne réentraîne pas le modèle. Il lui fournit un contexte au moment de la demande. Cela évite un réentraînement pour chaque mise à jour documentaire, mais ajoute son propre coût d’indexation, de recherche et de contexte. La qualité dépend fortement de la recherche, du découpage documentaire et des consignes de citation.
Une implémentation courante découpe les documents en passages et calcule des embeddings, représentations numériques utilisées pour retrouver des contenus proches. Une recherche par mots-clés ou une recherche hybride peut aussi être employée : le RAG ne se réduit pas à une base vectorielle. Le corpus et l’index doivent être actualisés lorsque les documents changent.
Exemple illustratif
Exemple pédagogique : un salarié demande “quelle est la politique de remboursement des frais de train ?”. Le système cherche les passages pertinents dans la politique interne, ajoute ces extraits au contexte, puis génère une réponse avec la source du paragraphe. L’exemple illustre la logique ; il ne garantit pas qu’un moteur précis soit configuré ici.
À ne pas confondre
- RAG et fine-tuning : le RAG apporte des documents au moment de répondre ; le fine-tuning modifie le comportement du modèle par entraînement.
- RAG et recherche simple : la recherche trouve des documents ; le RAG les utilise pour générer une réponse.
- RAG et vérité garantie : un mauvais document récupéré peut produire une mauvaise réponse.
Limites et sécurité
Les risques principaux sont la récupération de documents non pertinents, les passages obsolètes, les permissions mal appliquées et les documents piégés. Si un utilisateur n’a pas le droit de voir un fichier, le RAG ne doit pas le lui révéler indirectement dans une réponse.
La confidentialité impose aussi de gérer les embeddings, les index, les journaux de requêtes et les extraits envoyés au modèle. Un RAG utile doit citer ou identifier ses sources, signaler quand il ne sait pas et éviter de masquer l’incertitude derrière une réponse fluide.
Usage associé
Le RAG est pertinent quand la réponse dépend de documents évolutifs : procédures, fiches produit, contrats, FAQ interne. Pour démarrer proprement, testez un petit corpus, contrôlez les citations, mesurez les erreurs, puis élargissez progressivement.
Quand l’utiliser dans un projet
Le RAG est utile quand la réponse dépend d’un corpus que le modèle ne connaît pas forcément : documentation produit, procédures internes, offres commerciales, notes juridiques, articles ou tickets support. Il est particulièrement intéressant lorsque ces documents changent souvent, car il évite de réentraîner un modèle à chaque mise à jour.
Avant de généraliser, testez le RAG sur des questions connues avec une réponse attendue. Vérifiez si le système retrouve le bon passage, s’il ignore les documents hors sujet et s’il accepte de dire qu’il ne sait pas. Un RAG fiable n’est pas celui qui répond à tout, mais celui qui sait limiter sa réponse aux sources récupérées et signaler les trous documentaires.
Le choix des documents est aussi important que le modèle. Une base obsolète, dupliquée ou contradictoire peut dégrader la réponse même avec un excellent LLM. Nettoyer les sources, dater les pages et retirer les brouillons non validés fait partie du travail RAG.
Pour aller plus loin
La fiche sur les grands modèles de langage décrit le moteur de génération. Le guide d’installation d’Ollama permet de découvrir une brique locale : installer Ollama seul ne crée pas un système RAG.
Retrouvez les autres notions dans le lexique IA et automatisation de Gridpak.


