

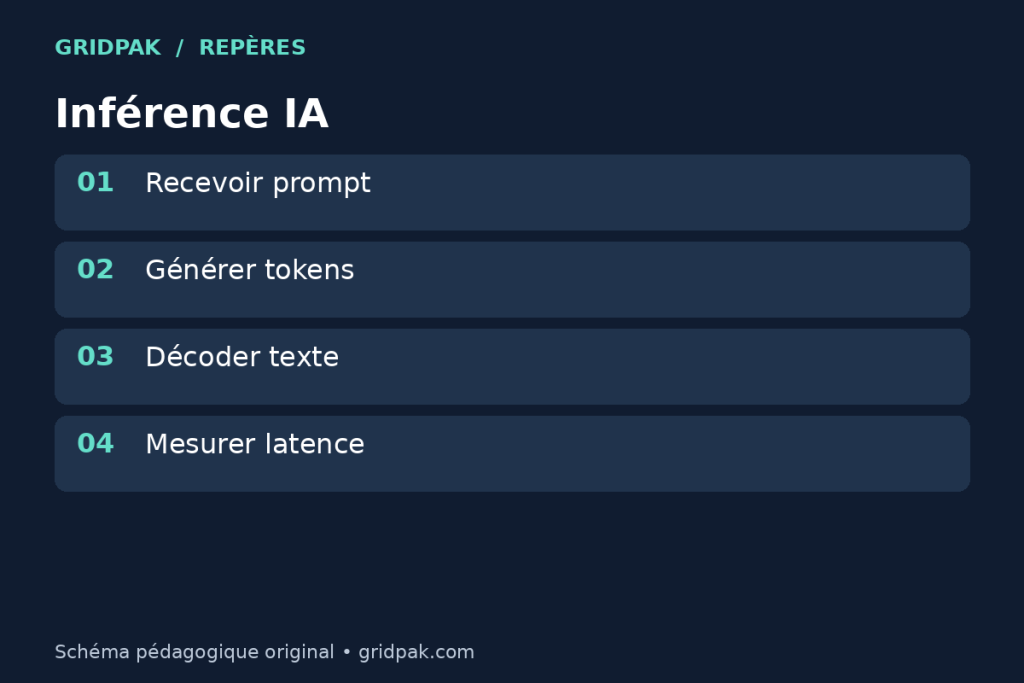
L’inférence est le moment où un modèle déjà entraîné reçoit une entrée et produit une sortie. Les poids ne sont pas mis à jour par cette génération. Votre application peut enregistrer des logs, des prompts ou des réponses pour analyse future, mais le modèle ne “s’améliore” pas automatiquement pendant qu’il répond.
Repère documentaire : documentation officielle du fonctionnement présenté.
Deux phases : prefill puis décodage
Dans un LLM, la première phase consiste à lire le prompt et à construire l’état interne nécessaire à la génération. On parle souvent de prefill. Plus le prompt est long, plus cette phase peut coûter en mémoire et en temps. La deuxième phase est le décodage : le modèle choisit un token, l’ajoute au contexte, puis recommence pour produire le token suivant.
Premier token vs débit
Deux métriques ne mesurent pas la même chose. Le temps jusqu’au premier token indique le délai avant que l’utilisateur voie la réponse démarrer. Il dépend beaucoup du prefill, de la file d’attente, du chargement modèle et du matériel. Le débit indique combien de tokens par seconde sortent ensuite. Un système peut démarrer vite mais écrire lentement, ou démarrer lentement puis générer rapidement.
Batch et concurrence
Sur serveur, plusieurs requêtes peuvent être regroupées ou planifiées ensemble. Le batching améliore parfois le débit global, mais il peut augmenter la latence d’une requête isolée. C’est pour cela qu’une mesure locale dans un terminal ne suffit pas à promettre la performance d’une API utilisée par dix personnes en même temps. Il faut préciser : modèle, taille du prompt, nombre de tokens générés, matériel, concurrence, quantification et version du runtime.
Exemple concret
Un résumé de 200 mots avec un prompt court sollicite peu le prefill et produit peu de tokens. Une analyse de 40 pages consomme beaucoup d’entrée avant même le premier mot. Une extraction JSON très longue peut avoir un prefill moyen mais un décodage coûteux. Dans les trois cas, “l’inférence” est le même principe, mais le goulot d’étranglement change.
À ne pas confondre
- Inférence : utiliser le modèle pour répondre.
- Entraînement : ajuster les poids avec des données.
- Fine-tuning : entraînement supplémentaire sur un modèle existant.
- RAG : ajouter des documents retrouvés au contexte d’inférence.
Si une réponse est mauvaise, relancer l’inférence peut produire autre chose selon les paramètres de sampling. Mais sans entraînement ou changement de contexte, le modèle sous-jacent reste le même. Pour améliorer le résultat, on agit sur le prompt, les sources, les paramètres de génération, le modèle, ou un entraînement séparé.
Pourquoi la mémoire monte avec le contexte
Pendant le décodage, le système réutilise les informations d’attention déjà calculées. C’est efficace, mais cela consomme de la mémoire avec la longueur de contexte et le nombre de requêtes simultanées. Un modèle qui répond bien à un utilisateur peut devenir lent à cinq utilisateurs si le serveur garde plusieurs caches en parallèle.
Instrumentation minimale
Pour diagnostiquer l’inférence, notez le modèle, la longueur du prompt, le nombre de tokens produits, le temps avant premier token, le temps total et les erreurs. Sans ces champs, vous ne saurez pas si le problème vient du prompt, du modèle, du matériel ou du serveur.
Pour les bases : définition d’un modèle de langage.


