

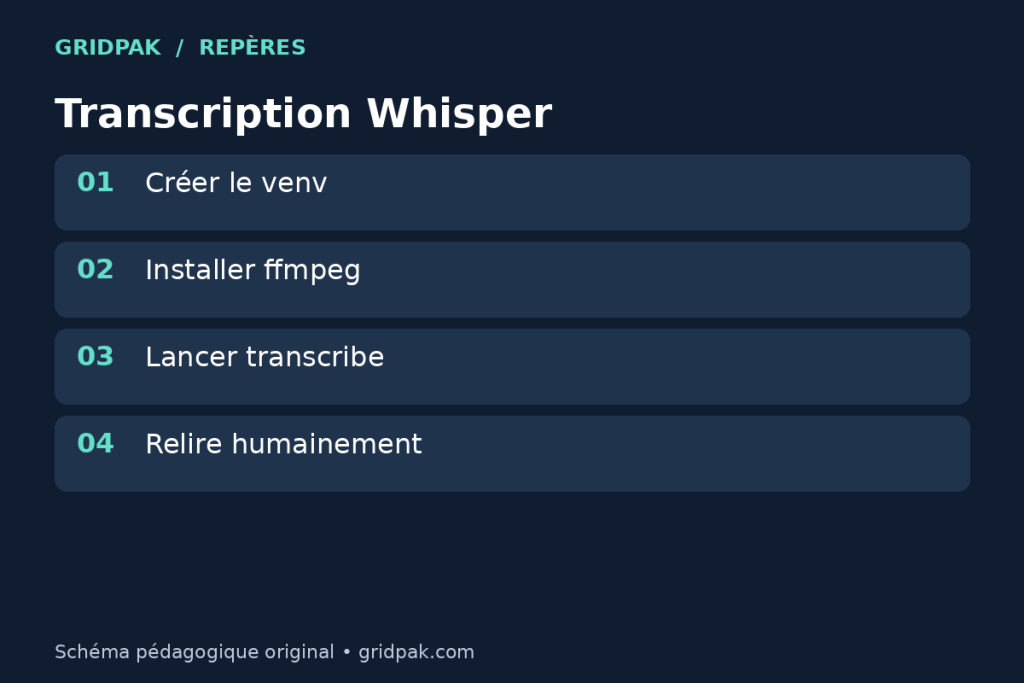
Whisper permet de transcrire un fichier audio ou vidéo en texte depuis une machine locale. La procédure ci-dessous vise Linux, pas Windows ni macOS. Elle est documentaire : elle donne les commandes et vérifications à exécuter, mais aucun benchmark de vitesse n’est revendiqué ici.
Repère documentaire : documentation officielle du fonctionnement présenté.
1. Vérifier Python et ffmpeg
Commencez par confirmer que Python et ffmpeg sont disponibles. Whisper dépend de ffmpeg pour lire et convertir les médias.
python3 --version
ffmpeg -version
Si ffmpeg est absent sur Debian/Ubuntu :
sudo apt update
sudo apt install ffmpeg
Évitez d’installer dans un Python système cassant. Créez plutôt un environnement virtuel :
python3 -m venv .venv-whisper
source .venv-whisper/bin/activate
pip install -U pip
pip install -U openai-whisper
2. Lancer une transcription propre
Les chemins avec espaces doivent être entre guillemets. Créez un dossier de sortie, puis demandez explicitement le format voulu.
mkdir -p sorties-whisper
whisper "interview client 01.mp3"   --model small   --language French   --task transcribe   --output_dir sorties-whisper   --output_format txt
Pour obtenir des sous-titres :
whisper "interview client 01.mp3" --model small --language French --task transcribe --output_dir sorties-whisper --output_format srtLe README de Whisper montre aussi l’usage de --model, --language et --task. Le choix small est souvent un compromis raisonnable pour tester. medium peut améliorer certains cas mais demande plus de ressources ; il ne faut pas promettre une vitesse ou une qualité sans mesurer sur votre machine et vos fichiers.
3. Problèmes fréquents
- ffmpeg not found : ffmpeg n’est pas installé ou pas dans le PATH.
- No such file : chemin mal cité, espace non échappé ou mauvais dossier courant.
- Permission denied : le fichier ou le dossier de sortie n’est pas lisible/écrivable par l’utilisateur.
- Transcription vide : fichier silencieux, piste audio absente, volume trop faible ou mauvais canal.
- Python/pip conflict : venv non activé ou installation dans un Python différent.
4. Améliorer la qualité sans magie
Un mauvais micro, de la musique forte ou plusieurs personnes qui parlent en même temps dégradent la transcription. Avant de changer de modèle, testez un extrait court, vérifiez l’audio avec ffprobe ou un lecteur, puis comparez small et medium sur la même minute. Pour un podcast long, segmentez si nécessaire et conservez le fichier original. Pour des sous-titres, relisez toujours les noms propres, chiffres, sigles et phrases coupées.
La bonne sortie dépend de l’usage : txt suffit pour un compte rendu ; srt sert au montage ; vtt peut être préférable pour le web. Ne mélangez pas transcription et traduction : --task transcribe garde la langue, --task translate vise une traduction vers l’anglais selon les capacités du modèle.
Préparer un fichier problématique
Si Whisper échoue ou donne une sortie étrange, créez un extrait court et propre pour tester. Exemple documentaire : ffmpeg -i "interview client 01.mp3" -t 60 -ac 1 -ar 16000 extrait.wav. Cette commande extrait une minute, convertit en mono et fixe un échantillonnage standard. Elle ne garantit pas une meilleure transcription, mais elle isole les problèmes de format ou de piste audio.
Organisation des livrables
Pour un usage régulier, nommez les sorties avec date, source et modèle : 2026-09-26-interview-small.srt. Gardez aussi une note indiquant langue, modèle, corrections manuelles et passages inaudibles. C’est indispensable si la transcription sert à un article, un sous-titre public ou une archive client.
Contrôle final
Relisez surtout les nombres, noms propres, marques, lieux, dates et négations. Une erreur sur “ne pas envoyer” transformée en “envoyer” peut changer le sens. La transcription automatique accélère la première passe ; elle ne remplace pas la validation quand le texte a une conséquence éditoriale ou juridique.
Traitement par lots sans écraser les fichiers
Pour plusieurs interviews, ne lancez pas tout dans le même dossier avec des noms vagues. Créez un dossier par source ou par date, puis vérifiez qu’un fichier audio n’a pas déjà une transcription relue. Exemple de règle : audio original dans audio/, sortie brute Whisper dans transcriptions-brutes/, version corrigée dans transcriptions-validees/. Cela évite de remplacer une version corrigée par une sortie automatique relancée plus tard.
Si vous traitez un lot hétérogène, commencez par trois fichiers représentatifs : un son propre, un son bruité, un fichier long. Ce test donne une idée des problèmes réels avant de laisser tourner la machine toute la nuit.
Validation éditoriale
Pour publier une transcription, ajoutez une passe humaine sur les passages à fort risque : noms propres, citations directes, chiffres, marques et formulations négatives. Si une phrase est inaudible, marquez-la plutôt que de la deviner. Une transcription propre est celle dont les incertitudes sont visibles.
Cas vidéo
Pour un fichier MP4, Whisper extrait l’audio via ffmpeg. Si la vidéo contient plusieurs pistes, vérifiez la bonne piste avant transcription. Un export muet ou une piste commentaire peut expliquer une sortie vide.
Langue déclarée
Indiquez la langue quand vous la connaissez. Laisser la détection automatique peut marcher, mais sur un extrait court, bruité ou bilingue, préciser --language French réduit les surprises et rend le traitement plus reproductible.
Pour les bases : définition d’un modèle de langage.
Sources officielles
Confidentialité et locuteurs
Vérifiez vos droits sur l’enregistrement avant de le transcrire. L’exécution locale ne dispense pas de protéger le fichier original, les exports et les sauvegardes. La commande présentée ne sépare pas automatiquement les locuteurs : attribuer chaque réplique exige une relecture ou un traitement de diarisation distinct. Des passages silencieux ou bruités peuvent produire des mots sans rapport avec l’audio ; contrôlez-les à l’écoute.


